Huawei объявила о разработке архитектуры интерконнекта нового поколения UnifiedBus (UB). Технология призвана решить проблемы скорости передачи данных в крупномасштабных вычислительных кластерах, ориентированных на ресурсоёмкие задачи ИИ.
В традиционных системах для ЦОД эффективность использования ресурсов снижается по мере масштабирования платформы. Так, в кластере из 100 тыс. NPU фактически задействуется всего около 20 % доступной вычислительной мощности, в то время как оставшиеся ресурсы простаивают в ожидании данных, утверждает Huawei. Обучение модели с триллионами параметров требует передачи колоссальных объёмов промежуточных сведений, а современные ИИ-агенты регулярно генерируют запросы, создавая постоянную нагрузку на коммуникационные линии.
Всё это приводит к необходимости гибкого перераспределения меняющейся нагрузки между CPU и NPU. Кроме того, резко возрастают требования к хранению данных на всех уровнях вычислительных платформ. В результате, недостаточная пропускная способность интерконнекта становится главным узким местом, ограничивающим производительность современных ИИ-кластеров.
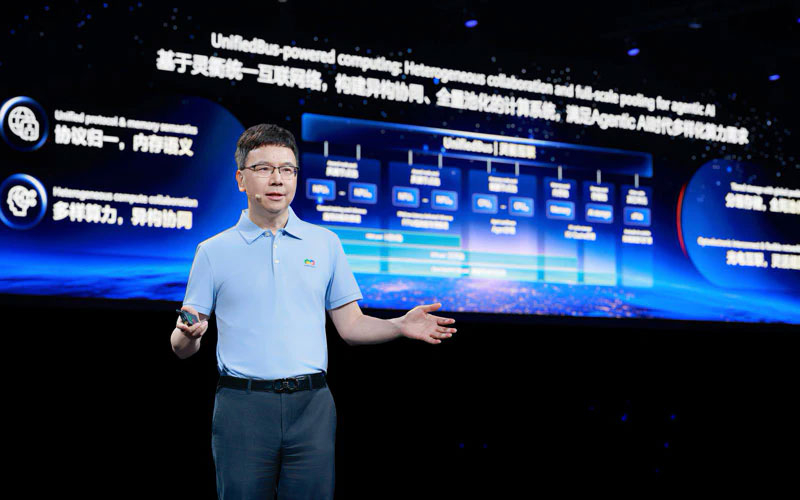
Архитектура UnifiedBus позволяет устранить существующие недостатки, объединив более десяти различных протоколов и увеличив общую пропускную способность интерконнекта с примерно 100 Гбайт/с до уровня в несколько Тбайт/с, тогда как задержка (RTT) уменьшается с 7 до 2 мкс. Новая архитектура также предусматривает единую глобальную адресацию памяти внутри ИИ-узлов SuperPoD. Помимо этого, UnifiedBus напрямую соединяет CPU, NPU, RAM и SSD, обеспечивая децентрализованную одноранговую связь между ними и гибкое распределение имеющихся ресурсов.
В рамках концепции UnifiedBus чипы DDR выступают в качестве альтернативной памяти для NPU, снижая задержки для поисковых, рекомендательных и других сервисов, а также удваивая производительность векторного поиска. При этом сокращаются требования к ёмкости HBM в составе ИИ-ускорителей. В целом, UnifiedBus служит глобальной «магистралью данных» со сверхвысокой пропускной способностью и малой задержкой, обеспечивая гибкое масштабирование вычислительных ресурсов.
Специальный модуль интерконнекта UnifiedBus LinkBlade с бескабельным дизайном обеспечивает высокоскоростную связь внутри стоек вычислительного кластера. Утверждается, что в составе SuperPoD с 4096 NPU применение LinkBlade позволяет сэкономить около 196 км медных соединений. Для обмена данными между отдельными стойками решение UnifiedBus LinkDevice предлагает 176 портов с пропускной способностью 1,6 Тбит/с каждый, обеспечивая полностью оптическое соединение со скоростью 280 Тбит/с. При этом могут формироваться кластеры с миллионами NPU.
Huawei продемонстрировала суперкластер для работы с агентным ИИ на базе UnifiedBus, который состоит из узлов SuperPoD TaiShan 950 и Atlas 960, хранилища данных OceanStor M900 и коммутатора Xinghe UBG. Эта платформа поддерживает многоуровневое объединение ресурсов, обеспечивая эффективную работу с различными нагрузками.
