Внимание
Мы работаем в штатном режиме. Наши склады готовы поставлять оборудование клиентам из Российской Федерации несмотря на санкционные запреты ЕС и США. Оборудование в РФ ввозится легально благодаря новому законодательству с параллельным импортом. Звоните и уточняйте! Информация актуальна на 22.10.26В связи с участившимися случаями недобросовестной конкуренции обращаем ваше внимание, что мы не передаем персональные данные третьим лицам


Поиск по сайту


Видеокарта NVIDIA H800 80GB PCIe HBM2e




Наличие по запросу
Почему нет цен?
Уточнить цену
Гарантия до 5 лет

Диагностика перед отправкой

С нами выгодно и удобно!
- Поддержка персонального менеджера
- Партнёрские скидки до 70%
- Онлайн-кабинет гарантийного сервиса
?
Как купить?
Раз, два и все делаРассчитаем стоимость
Присылайте спецификацию для подбора и расчета стоимости оборудования
1Раз
Привезём и подключим
Подключим и настроим оборудование в вашем офисе или ЦОДе
2Два
Характеристики
Производитель
Модель
H800
Тип видеопамяти
HBM3
PCIe
PCIe Gen 5.0, x16 lanes
Архитектура
NVIDIA Hopper
Объем видеопамяти
94 GB
Лицензии
NVIDlA Al Enterprise Essentials Subscription per GPU, 1 Year one Year subscription
Лицензия NVIDlA Al Enterprise Essentials Subscription per GPU, 1 Year one Year subscription
NVIDIA Al Enterprise Essentials Perpetual License & Support per GPU, Permanent + 5 Years Original Service
Лицензия NVIDIA Al Enterprise Essentials Perpetual License & Support per GPU, Permanent + 5 Years Original Service
NVIDlA Al Enterprise Essentials Subscription per GPU, 3 Year one Year subscription
Лицензия NVIDlA Al Enterprise Essentials Subscription per GPU, 3 Year one Year subscription
Соберите свою конфигурацию
Описание
NVIDIA H800 PCIe NVL — это тензорный GPU-ускоритель дата-центрового класса на архитектуре NVIDIA Hopper, ориентированный на обучение и инференс крупных языковых моделей (LLM), глубокое обучение, высокопроизводительные вычисления (HPC) и масштабируемые AI‑нагрузки в серверных платформах с интерфейсом PCI Express Gen5 и межсоединением NVLink. В официальных материалах H800 PCIe/NVL описывается как адаптированный для ряда регионов вариант флагманского решения на базе Hopper, сохранивший полную вычислительную конфигурацию GPU, поддержку FP8/FP16/TF32/FP64 и Transformer Engine, но с изменёнными параметрами подсистемы памяти и энергопотребления. В продуктовых гайдах указывается, что стандартный адаптер H800 PCIe оснащён 80 ГБ памяти HBM2e с полосой пропускания до 2 ТБ/с, а версия H800 NVL PCIe — 94 ГБ памяти HBM3 с полосой пропускания до 3,9 ТБ/с, при этом оба варианта используют PCIe Gen5 x16 и NVLink c пропускной способностью до 400 ГБ/с между GPU. Для NVL‑исполнения H800 типичное энергопотребление указывается на уровне около 400 Вт, а для стандартного PCIe — 350 Вт, что позволяет строить энергоэффективные кластеры с высокой плотностью размещения GPU и соблюдением требований по теплопакету.
Архитектура и ключевые характеристики
Согласно официальному продукт‑гиду Lenovo ThinkSystem NVIDIA H800 PCIe Gen5 GPUs, ускорители H800 построены на архитектуре NVIDIA Hopper и используют тот же полный набор вычислительных блоков, что и H100: 14 592 ядра CUDA FP32 и 528 тензорных ядер четвёртого поколения на один GPU. В документации подчёркивается, что H800 сохраняет поддержку Transformer Engine и тензорных операций FP8/FP16/TF32, что позволяет достигать пиковых значений производительности на уровне нескольких тысяч TFLOPS в FP8 и до нескольких тысяч TOPS в INT8, сопоставимых с H100 (для FP8 до 3 958 TFLOPS для стандартной Hopper‑конфигурации, что приводится в архитектурных данных). В китайском даташите по H800 отдельно отмечается, что архитектура Hopper и полная конфигурация 14 592 CUDA‑ядер и 528 Tensor Core оставлены «без урезаний» относительно H100, а ключевые отличия касаются подсистемы памяти и энергопотребления.
В таблице характеристик Lenovo ThinkSystem для H800 PCIe/NVL указано, что стандартный адаптер H800 PCIe оснащён 80 ГБ памяти HBM2e и обеспечивает пропускную способность до 2 ТБ/с, в то время как адаптер H800 NVL PCIe имеет 94 ГБ HBM3 с пропускной способностью до 3,9 ТБ/с. Оба варианта поддерживают ECC, обеспечивая обнаружение и коррекцию ошибок в памяти, что критично для многосуточных вычислений и обучения крупных моделей. В том же источнике приводятся значения пропускной способности межсоединений: NVLink до 400 ГБ/с и PCIe Gen5 x16 до 128 ГБ/с, что обеспечивает баланс между локальным доступом к памяти и межузловыми коммуникациями в составе GPU‑серверов. В китайском описании H800 NVL отдельно указана типичная мощность 400 Вт для NVL‑варианта и 350 Вт для стандартного PCIe‑адаптера, а также возможность конфигурируемого TDP в диапазоне 300–350 Вт в зависимости от профиля развертывания.
Даташит NVIDIA H800 Tensor Core GPU отмечает наличие до 7 блоков NVDEC и 7 JPEG‑ускорителей на GPU, поддержку до 7 MIG‑партиций (Multi‑Instance GPU), где для стандартного 80‑гигабайтного варианта доступно до 7 экземпляров по 10 ГБ, а для NVL‑варианта — до 7 экземпляров по 12 ГБ, что обеспечивает гибкое разделение GPU между несколькими рабочими нагрузками. Там же указаны рабочие температурные диапазоны для воздушного и жидкостного охлаждения, а также форма‑фактор: SXM и PCIe двойной ширины с воздушным охлаждением. Для PCIe‑адаптера H800 используется шина PCIe 5.0 x16, обеспечивающая пропускную способность до 128 ГБ/с, а межсоединение NVLink между GPU обеспечивает до 400 ГБ/с, что позволяет использовать H800 NVL в составе многокарточных конфигураций для обучения и инференса крупных моделей.
Сценарии применения
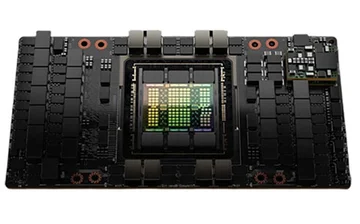
В официальном гайде Lenovo и документации NVIDIA H800 NVL характеризуется как профильный ускоритель для инференса и обучения больших языковых моделей (LLM), а также для типовых задач глубокого обучения и HPC, требующих высокой пропускной способности памяти и межсоединений. Благодаря архитектуре Hopper, поддержке FP8/FP16/TF32/FP32/FP64 и высокому объёму HBM‑памяти H800 PCIe NVL ориентирован на широкий спектр AI‑нагрузок, от тренировки и инференса до аналитики и симуляций.
- Идеально подходит для обучения нейросетей (Deep Learning), включая крупные трансформерные модели и LLM, где критичны поддержка FP8/FP16 и Transformer Engine, высокая вычислительная плотность (десятки PFLOPS в FP8 для многокарточных конфигураций) и пропускная способность памяти до 3,9 ТБ/с в NVL‑варианте.
- Предназначен для инференса LLM моделей и других систем обработки естественного языка, где задействуются методы квантования (FP8/INT8) и требуется низкая задержка при обработке большого числа параллельных запросов в кластерах с несколькими H800 NVL, объединёнными по NVLink.
- Ориентирован на высокопроизводительные вычисления (HPC), включая численное моделирование, методы конечных элементов, моделирование материалов и CFD, где используется высокая производительность в FP64/FP32 и большая полоса памяти, а также возможность разделения GPU на MIG‑instances для параллельного исполнения нескольких задач.
- Эффективен в задачах аналитики данных, графовых и статистических моделей, построения рекомендательных систем и обработки потоковых данных, где Hopper‑архитектура и тензорные ядра ускоряют линейную алгебру и матричные операции по сравнению с CPU‑только решениями.
- Подходит для создания гибридных кластеров CPU+GPU и систем для генеративного ИИ, где H800 PCIe NVL используется как базовый вычислительный ускоритель, а существующие приложения переносятся на CUDA, cuDNN, NCCL и другие библиотеки без серьёзной переработки кода, что подчёркивается в китайском описании «экосистема без изменения кода».
- Применяется в конфигурациях с высокой плотностью размещения GPU в стойке для задач корпоративного и облачного ИИ, когда энергопакет 350–400 Вт на GPU и поддержка PCIe Gen5/NVLink позволяют балансировать между производительностью и энергопотреблением в крупных ЦОД.
Совместимость
NVIDIA H800 PCIe NVL реализован в виде двойной по ширине PCIe Gen5 x16 карты с воздушным охлаждением и типичным энергопотреблением 350–400 Вт, что требует использования серверных платформ, поддерживающих PCIe Gen5 x16 и рассчитанных на работу с высокомощными GPU‑ускорителями. В продукт‑гайде Lenovo ThinkSystem указано, что адаптеры H800 PCIe и H800 NVL PCIe квалифицированы для работы в ряде серверов Lenovo ThinkSystem, при этом отдельно описаны требования к слоту, питанию и охлаждению. Документация NVIDIA по vGPU и AI Enterprise отмечает поддержку виртуализации для H800 PCIe 94GB (H800 NVL), что также подразумевает наличие квалифицированных OEM‑конфигураций.
- Ускоритель протестирован на совместимость с серверными платформами: Dell PowerEdge, что отражено в отраслевых обзорах GPU‑серверов и конфигурациях с PCIe Gen5, где указывается поддержка NVIDIA Hopper‑поколения (в том числе H800) в линейке PowerEdge XE/XE‑серий, рассчитанных на несколько PCIe Gen5 x16 GPU в одном шасси.
- Поддерживается в системах HPE ProLiant и связанных решениях, где через OEM‑каналы (например, HPE dHCI и ProLiant DL‑серии, упомянутые для родственных продуктов V100S и других Tesla/Hopper‑ускорителей) реализуются конфигурации с PCIe Gen5 GPU, аналогичные H800 PCIe NVL по требованиям к питанию и охлаждению.
- Совместим с серверными платформами Supermicro, ориентированными на GPU‑нагрузки, где в сравнительных гайдах по GPU‑серверам отмечается поддержка PCIe Gen5 x16 и многокарточных конфигураций для семейства NVIDIA Hopper, используемого в том числе в региональных вариантах H800.
- Может использоваться и в других серверных системах, которые соответствуют требованиям по интерфейсу PCIe 5.0 x16, форм-фактору dual‑slot, обеспечивают до 350–400 Вт на слот и необходимый воздушный или жидкостный тепловой контур, как указано в даташите NVIDIA H800 Tensor Core GPU и продукт‑гайде Lenovo ThinkSystem.
Надёжность и эксплуатация в ЦОД
В официальном даташите NVIDIA H800 Tensor Core GPU подчёркивается, что ускоритель ориентирован на круглосуточную эксплуатацию в центрах обработки данных, где критичны стабильность, управляемое энергопотребление и высокая эффективность на ватт. Конфигурируемый TDP (300–350 Вт для PCIe и до 400 Вт для NVL), поддержка воздушного и жидкостного охлаждения и рабочие температурные диапазоны, описанные в китайской документации, позволяют адаптировать H800 к различным типам дата‑центров и инфраструктур. Поддержка ECC для HBM‑памяти и механизмов Multi‑Instance GPU (MIG) обеспечивает высокий уровень отказоустойчивости и изоляции между рабочими нагрузками, что важно при консолидации сервисов на одном GPU.
Документация NVIDIA AI Enterprise и vGPU указывает на наличие профилей виртуальных GPU для H800 PCIe 94GB (H800 NVL), что позволяет эффективно делить ресурсы между несколькими виртуальными машинами и контейнерами без потери производительности. В сочетании с квалифицированными серверными платформами (Lenovo ThinkSystem, а также системами Dell, HPE, Supermicro с PCIe Gen5 и поддержкой высокомощных GPU) это упрощает развёртывание масштабируемых кластеров для LLM, Deep Learning и HPC‑нагрузок. Архитектура Hopper, полный набор CUDA‑ и тензорных ядер, 80–94 ГБ HBM‑памяти с полосой пропускания до 3,9 ТБ/с и поддержка NVLink делают NVIDIA H800 PCIe NVL надёжной и высокопроизводительной основой для современных инфраструктур обучения нейросетей, инференса LLM и высокопроизводительных вычислений в крупных центрах обработки данных.
Официальное сертифицированное оборудование
Бесплатный
подбор оборудования
подбор оборудования
Расчёт КП за 20 минут
Отсрочка платежа
до 90 дней
до 90 дней
Доставка по Москве 2-3 дня