Внимание
Мы работаем в штатном режиме. Наши склады готовы поставлять оборудование клиентам из Российской Федерации несмотря на санкционные запреты ЕС и США. Оборудование в РФ ввозится легально благодаря новому законодательству с параллельным импортом. Звоните и уточняйте! Информация актуальна на 25.10.26В связи с участившимися случаями недобросовестной конкуренции обращаем ваше внимание, что мы не передаем персональные данные третьим лицам


Поиск по сайту


Видеокарта NVIDIA Tesla M40 12GB GDDR5
Наличие по запросу 


 Прямой импорт оборудования
из Китая и ОАЭ без посредников
Наличие по запросу
Почему нет цен?
Уточнить цену
Гарантия до 5 лет

Диагностика перед отправкой

С нами выгодно и удобно!
- Поддержка персонального менеджера
- Партнёрские скидки до 70%
- Онлайн-кабинет гарантийного сервиса
?
Как купить?
Раз, два и все делаРассчитаем стоимость
Присылайте спецификацию для подбора и расчета стоимости оборудования
1Раз
Привезём и подключим
Подключим и настроим оборудование в вашем офисе или ЦОДе
2Два
Характеристики
Производитель
Модель
Tesla M40-12GB
Тип видеопамяти
GDDR5
Потребляемая мощность
250W
Архитектура
Maxwell
CUDA ядра
3072
Объем видеопамяти
12 GB
Совместимость с NVIDIA Tesla M40 12GB GDDR5
Серверы xFusion

Серверы HPE
Лицензии
NVIDlA Al Enterprise Essentials Subscription per GPU, 2 Years one Year subscription
Лицензия NVIDlA Al Enterprise Essentials Subscription per GPU, 2 Years one Year subscription
NVIDIA Al Enterprise Essentials Perpetual License & Support per GPU, Permanent + 5 Years Original Service
Лицензия NVIDIA Al Enterprise Essentials Perpetual License & Support per GPU, Permanent + 5 Years Original Service
NVIDlA Al Enterprise Essentials Subscription per GPU, 1 Year one Year subscription
Лицензия NVIDlA Al Enterprise Essentials Subscription per GPU, 1 Year one Year subscription
Описание
NVIDIA Tesla M40 12GB — это серверный GPU-ускоритель на архитектуре Maxwell, изначально спроектированный для задач глубокого обучения, высокопроизводительных вычислений и обработки больших массивов данных в составе серверов и кластеров дата-центров. В официальных материалах NVIDIA Tesla M40 описывается как двухслотовая плата PCI Express Gen3 с одним GPU Maxwell GM200, ориентированная на ускорение обучения нейросетей и работу с современными фреймворками машинного обучения. Конфигурация с 12 ГБ памяти GDDR5 и широкой 384‑битной шиной памяти обеспечивает высокую пропускную способность порядка 288 ГБ/с, что позволяет эффективно загружать GPU данными и минимизировать узкие места при обработке крупных батчей и моделей. Tesla M40 не имеет видеовыходов, использует пассивное охлаждение и поставляется в форм‑факторе полноразмерной двухслотовой карты (4,4″ × 10,5″), рассчитанной на установку в серверные шасси с направленным воздушным потоком. Поддержка стандартных вычислительных API — CUDA, DirectCompute, OpenCL и OpenACC — упрощает интеграцию ускорителя в существующие программные стеки для HPC и машинного обучения.
Архитектура и ключевые характеристики
Согласно официальному даташиту, NVIDIA Tesla M40 основана на графическом процессоре Maxwell GM200 с 3072 ядрами CUDA, что обеспечивает высокую вычислительную плотность и позволяет достигать до 6,84 TFLOPS производительности в одинарной точности (FP32) при базовых частотах порядка 948–1114 МГц. Архитектура Maxwell использует 24 потоковых мультипроцессора (SM), 192 текстурных блока (TMU) и 96 блоков растеризации (ROP), а также 3 МБ кеша L2, что оптимизирует работу с памятью и повышает эффективность при обработке графов вычислений в нейросетевых и аналитических приложениях. В спецификациях отмечено, что производительность в двойной точности (FP64) составляет порядка 210 GFLOPS, что указывает на ориентацию карты преимущественно на FP32‑вычисления и задачи искусственного интеллекта, менее чувствительные к FP64. Интерфейс PCI Express 3.0 x16 обеспечивает высокую пропускную способность обмена данными с хост‑системой и другими устройствами, что критично для гибридных конфигураций CPU+GPU.
Подсистема памяти Tesla M40 12GB представлена 12 ГБ GDDR5, подключённой по 384‑битной шине с эффективной частотой 6 ГТ/с, что даёт суммарную пропускную способность 288 ГБ/с. Такой объём и скорость памяти позволяют работать с крупными моделями, батчами и массивами данных без постоянной пересылки в оперативную память CPU, что особенно важно при обучении нейросетей и выполнении больших матричных операций. Максимальное энергопотребление платы по даташиту составляет до 250 Вт, при этом карта использует пассивное охлаждение и рассчитана на установку в серверы с достаточным воздушным потоком и поддержкой дополнительных разъёмов питания (один 6‑контактный и один 8‑контактный PCIe, согласно сводным спецификациям). Форм‑фактор Tesla M40 — Full Height, Full Length, dual‑slot (4,4″ H × 10,5″ L), что учитывается при проектировании серверных платформ.
В официальных документах указывается, что Tesla M40 поддерживает вычислительные API CUDA, DirectCompute, OpenCL и OpenACC, что позволяет использовать ускоритель как в специализированных фреймворках машинного обучения (через CUDA), так и в более широких вычислительных стэках. Архитектура Maxwell обеспечивает улучшенную энергоэффективность по сравнению с предыдущим поколением Kepler, благодаря оптимизации SM‑блоков и кешей, что даёт больше производительности на ватт для задач обучения и инференса. В описаниях продукта упоминается, что Tesla M40 поставляется в вариантах с 12 и 24 ГБ памяти GDDR5, при этом общие архитектурные характеристики остаются одинаковыми; в данном случае рассматривается версия с 12 ГБ, что важно при подборе под конкретные задачи и модели.
Сценарии применения
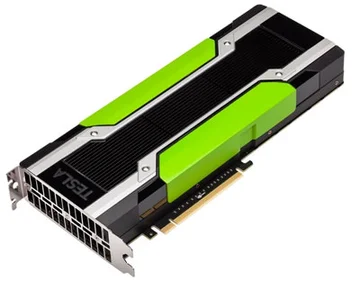
В официальных материалах NVIDIA Tesla M40 позиционируется как специализированный GPU‑ускоритель для глубокого обучения, ориентированный на обучение нейросетей и инференс в средах дата-центров. Максимальная производительность в FP32, большой объём памяти и высокая пропускная способность делают карту подходящей для целого ряда задач искусственного интеллекта и высокопроизводительной аналитики.
- Идеально подходит для обучения нейросетей (Deep Learning), в том числе сверточных и рекуррентных архитектур, где требуется высокая производительность в одинарной точности и объём видеопамяти 12 ГБ для размещения моделей и батчей данных; в описании отмечается, что Tesla M40 разрабатывалась именно как ускоритель для обучения нейросетей.
- Подходит для инференса LLM моделей и других задач обработки естественного языка, когда используются модели и фреймворки, оптимизированные под архитектуру Maxwell и FP32/INT‑вычисления, и требуется высокая вычислительная плотность при развертывании в серверной инфраструктуре.
- Ориентирована на высокопроизводительные вычисления (HPC) в областях, где преобладают FP32‑нагрузки: численные методы, анализ данных, построение моделей и прототипов, не критичных к большой доле FP64, при этом важна высокая пропускная способность памяти и массовый параллелизм.
- Может использоваться в аналитике данных и рекомендательных системах, где GPU отвечает за быстрое вычисление векторных представлений, обработку больших массивов признаков и матричные операции, ускоряя типовые задачи аналитики и data mining.
- Подходит для задач визуализации результатов вычислений и постобработки, когда рендеринг или подготовка визуальных данных выполняются на GPU без необходимости наличия видеовыходов; результаты могут передаваться в другие компоненты системы или сохраняться для последующей обработки.
- Используется в исследовательских и академических средах для создания стендов по глубокому обучению и высокопроизводительной аналитике, где важен баланс между стоимостью, производительностью и объёмом памяти GPU.
Совместимость
Ускоритель NVIDIA Tesla M40 12GB спроектирован как двухслотовый модуль PCI Express 3.0 x16 с пассивным охлаждением и TDP до 250 Вт, что предполагает установку в серверные платформы, рассчитанные на подобный класс GPU‑ускорителей. Для корректной работы необходимы слоты PCIe Gen3 x16, дополнительные разъёмы питания и достаточный воздушный поток внутри шасси, что отражено в официальных спецификациях и партнёрских материалах.
- Ускоритель протестирован на совместимость с серверными платформами: Dell PowerEdge, о чём свидетельствуют практические материалы и обсуждения эксплуатации Tesla M40 в серверах Dell, включая вопросы по питанию и охлаждению при использовании карт с TDP 250 Вт.
- Поддерживается в системах HPE ProLiant и других серверных платформах HPE, где Tesla M40 используется в качестве GPU‑ускорителя для задач глубокого обучения и HPC; наличие практического опыта эксплуатации Tesla M40 в сервере HPE ML350 Gen8 подтверждается отраслевыми материалами.
- Совместим с серверными платформами Supermicro, о чём свидетельствуют практические кейсы использования Tesla M40 в системах Supermicro с PCIe Gen3 и вопросами по обеспечению надлежащего уровня питания и охлаждения для GPU с потреблением до 250 Вт.
- Может использоваться и в других серверных системах, поддерживающих полноразмерные двухслотовые PCIe 3.0 x16 карты и обеспечивающих соответствующий тепловой и энергетический бюджет, при условии соблюдения рекомендаций NVIDIA по питанию (1× 6‑pin + 1× 8‑pin), воздушному потоку и размещению в стойке.
Надёжность и эксплуатация в ЦОД
В даташитах Tesla M‑серии подчёркивается, что NVIDIA Tesla M40 предназначена для круглосуточной эксплуатации в центрах обработки данных, где важны предсказуемое энергопотребление и стабильная работа при длительных нагрузках. Пассивная система охлаждения, требующая контролируемого воздушного потока, позволяет снизить количество подвижных частей в непосредственной близости к GPU и повышает общую надёжность системы при условии правильного проектирования шасси. Максимальное энергопотребление до 250 Вт учитывается при проектировании систем питания и охлаждения, а стандартизованный форм‑фактор FHFL dual‑slot облегчает интеграцию в типовые серверные платформы.
Поддержка стандартных вычислительных API (CUDA, OpenCL, OpenACC) и ориентированность на работу с популярными фреймворками глубокого обучения упрощают сопровождение программного стека и миграцию приложений между поколениями GPU. Практический опыт эксплуатации Tesla M40 в серверах Dell, HPE и Supermicro показывает необходимость соблюдения требований по питанию и охлаждению, что отмечено в профильных обсуждениях и статьях, посвящённых установке Tesla M40 в типовые стоечные серверы. В совокупности архитектура Maxwell, высокий уровень FP32‑производительности, большой объём видеопамяти, совместимость с серверными платформами ведущих вендоров и ориентация на ИИ‑нагрузки делают NVIDIA Tesla M40 12GB надёжным и востребованным ускорителем для развёртывания инфраструктур глубокого обучения и высокопроизводительной аналитики в современных ЦОД.
Официальное сертифицированное оборудование
Бесплатный
подбор оборудования
подбор оборудования
Расчёт КП за 20 минут
Отсрочка платежа
до 90 дней
до 90 дней
Доставка по Москве 2-3 дня