

Внимание
Мы работаем в штатном режиме. Наши склады готовы поставлять оборудование клиентам из Российской Федерации несмотря на санкционные запреты ЕС и США. Оборудование в РФ ввозится легально благодаря новому законодательству с параллельным импортом. Звоните и уточняйте! Информация актуальна на 30.10.26В связи с участившимися случаями недобросовестной конкуренции обращаем ваше внимание, что мы не передаем персональные данные третьим лицам


Поиск по сайту


Оборудование NVIDIA




722
Наличие по запросу
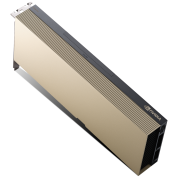


Видеокарта NVIDIA H100 80GB PCIe OEM — это вычислительный ускоритель на основе архитектуры Hopper, предназначенный для профессиональных задач искусственного интеллекта (ИИ), глубокого обучения и высокопроизводительных вычислений (HPC). Карта оснащена 16 896 ядрами CUDA, 80 ГБ памяти HBM3 с пропускной способностью до 3 ТБ/с и поддерживает интерфейс PCI Express 5.0 x16, обеспечивая высокую масштабируемость и эффективность обработки больших данных. NVIDIA H100 PCIe OEM поддерживает технологии Multi-Instance GPU (MIG), Transformer Engine с FP8, а также интегрируется с популярными ИИ-фреймворками, что делает её оптимальным выбором для дата-центров и корпоративных серверов.
5 069 041
₽ за 1 шт
Наличие по запросу
Наличие по запросу
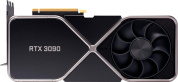


Видеокарта NVIDIA RTX 3090 Turbo OEM — это мощный графический ускоритель на базе чипа NVIDIA GeForce RTX 3090 с 10496 CUDA-ядрами и 24 ГБ видеопамяти GDDR6X. Карта использует активное охлаждение турбинного типа, что позволяет эффективно выводить горячий воздух из корпуса сервера или ПК и оптимальна для компактных систем с ограниченным потоком воздуха. Она поддерживает высокую частоту GPU до 1695 МГц в режиме Boost, интерфейс PCIe 4.0 x16, а максимальное энергопотребление составляет около 350 Вт, что требует мощного блока питания не менее 750 Вт.
115 305
₽ за 1 шт
Наличие по запросу
Наличие по запросу
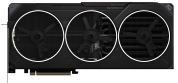

Видеокарта NVIDIA RTX 5090 32G Turbo — это флагманская модель 2025 года на архитектуре Blackwell 2.0 с 21 760 ядрами CUDA и тактовой частотой до 2,41 ГГц в режиме Turbo. Оснащена 32 ГБ памяти GDDR7 с 512-битной шиной и пропускной способностью 1,79 ТБ/с, что обеспечивает выдающуюся игровую и профессиональную производительность. Карта поддерживает интерфейс PCIe 5.0 x16, энергопотребление около 575 Вт и ориентирована на требовательные игры и задачи искусственного интеллекта.
393 847
₽ за 1 шт
Наличие по запросу
Наличие по запросу
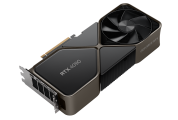


Видеокарта NVIDIA RTX 4090 48G Turbo OEM — это высокопроизводительный графический ускоритель, основанный на архитектуре Ada Lovelace с 16 384 ядрами CUDA и тактовой частотой до 2520 МГц в режиме Turbo. Карта оснащена 48 ГБ памяти GDDR6X и поддерживает интерфейс PCI Express 4.0 x16, что обеспечивает высокую пропускную способность и отличную игровую и профессиональную производительность. Turbo-версия характеризуется эффективной системой охлаждения и ориентирована на профессиональное использование в рабочих станциях и игровых системах.
383 939
₽ за 1 шт
Наличие по запросу
Наличие по запросу


GPU‑сервер NVIDIA с 8 ускорителями NVIDIA H100 (PCIe)
Блок питания
3300W
30 196 116
₽ за 1 шт
Наличие по запросу
Наличие по запросу


GPU‑сервер NVIDIA с 8 ускорителями NVIDIA H100 (SXM) представляет собой мощную вычислительную платформу для задач глубокого обучения и искусственного интеллекта, оснащённую восемью GPU NVIDIA H100 SXM5 с 80 ГБ памяти HBM3 на каждый ускоритель и пропускной способностью памяти до 3,35 ТБ/с. Сервер поддерживает NVLink 4.0 с NVSwitch, обеспечивая пропускную способность до 900 ГБ/с между GPU для эффективной синхронизации данных и масштабируемости вычислений. Платформа построена на базе процессоров Intel Xeon Scalable, поддерживает Multi-Instance GPU (MIG), Transformer Engine с FP8, и интегрируется с экосистемой NVIDIA AI Enterprise для использования в дата-центрах и суперкомпьютерах с высокой энергоэффективностью и надёжностью работы.
Блок питания
3300W
31 021 791
₽ за 1 шт
Наличие по запросу
Наличие по запросу


GPU‑сервер NVIDIA с 4 ускорителями NVIDIA H200 (PCIe) оснащён четырьмя графическими процессорами NVIDIA H200 NVL с 141 ГБ памяти HBM3e и пропускной способностью 4,8 ТБ/с на каждый ускоритель. Сервер поддерживает PCIe Gen5, NVLink 4.0 с NVSwitch, обеспечивая пропускную способность до 900 ГБ/с для эффективного обмена данными между GPU. Платформа построена на базе современных процессоров Intel Xeon Scalable или AMD EPYC с поддержкой DDR5 и сетевыми интерфейсами InfiniBand/Ethernet до 400 Гбит/с, интегрирована с экосистемой NVIDIA AI Enterprise, оптимизирована для задач ИИ, глубокого обучения и масштабируемых вычислений.
HDD
10x 2.5" NVMe
16 867 362
₽ за 1 шт
Наличие по запросу
Наличие по запросу


GPU‑сервер NVIDIA с 8 ускорителями NVIDIA H200 (PCIe) — это высокопроизводительная вычислительная платформа с восемью ускорителями NVIDIA H200 NVL, каждый оснащённый 141 ГБ памяти HBM3e и пропускной способностью 4,8 ТБ/с. Сервер поддерживает PCIe Gen5, NVLink 4.0 и NVSwitch с пропускной способностью до 900 ГБ/с, обеспечивая высокую скорость передачи данных между ускорителями и масштабируемость для нагрузок ИИ и HPC. Платформа построена на современных процессорах Intel Xeon Scalable и AMD EPYC с поддержкой DDR5 и сетевыми интерфейсами InfiniBand/Ethernet до 400 Гбит/с, интегрированными в экосистему NVIDIA AI Enterprise для оптимизации вычислительных задач и энергопотребления.
HDD
10x 2.5" NVMe
31 729 513
₽ за 1 шт
Наличие по запросу
Наличие по запросу


GPU‑сервер NVIDIA с 8 ускорителями NVIDIA H200 (SXM) представляет собой высокопроизводительную 8U платформу, оснащённую восемью графическими процессорами NVIDIA H200 NVL с 141 ГБ памяти HBM3e на каждый ускоритель и пропускной способностью 4,8 ТБ/с. Сервер поддерживает NVLink 4.0 с NVSwitch, обеспечивая пропускную способность до 900 ГБ/с для эффективного обмена данными между GPU, что важно для масштабируемых задач искусственного интеллекта и высокопроизводительных вычислений. Платформа построена на базе процессоров AMD EPYC 9005/9004 Series или Intel Xeon Sapphire Rapids/Emerald Rapids и оборудована современными системами хранения и сетевого взаимодействия с поддержкой 400 Гбит/с InfiniBand/Ethernet. Решение оптимизировано для ИИ, HPC и научных исследований с интеграцией в экосистему NVIDIA AI Enterprise.
HDD
10x 2.5" NVMe
33 970 631
₽ за 1 шт
Наличие по запросу
Наличие по запросу

GPU‑сервер NVIDIA с 8 ускорителями NVIDIA B200 (SXM) - это высокопроизводительная платформа, оснащённая восемью графическими процессорами NVIDIA B200 на архитектуре Blackwell, каждый с 192 ГБ памяти HBM3e и пропускной способностью памяти до 8 ТБ/с на ускоритель. Сервер поддерживает NVLink 5.0 и NVSwitch для коммутации с пропускной способностью до 1,8 ТБ/с между ускорителями GPU, что позволяет эффективно масштабировать вычислительные задачи ИИ и HPC. Платформа построена на базе двух процессоров Intel Xeon Platinum и оснащена современными системами хранения и сетевой инфраструктурой с пропускной способностью до 400 Гбит/с InfiniBand/Ethernet. Решение интегрировано с экосистемой NVIDIA AI Enterprise и предназначено для крупных дата-центров и научных проектов, обеспечивая высокую производительность и энергоэффективность.
HDD
2x 2.5" NVMe, 8x 2.5" NVMe
46 591 664
₽ за 1 шт
Наличие по запросу
Наличие по запросу
NVIDIA TAO — платформа для ускоренного обучения, адаптации и оптимизации моделей искусственного интеллекта с помощью трансферного обучения. Она позволяет быстро дообучать готовые нейросети без глубоких знаний в ИИ, поддерживает современные модели и автоматическую разметку данных. TAO интегрируется с сервисами NVIDIA, экспортирует модели для различных платформ и упрощает промышленное внедрение ИИ-продуктов.
Наличие по запросу
Наличие по запросу
NVIDIA PhysicsNeMo — открытая платформа для создания и обучения физически-информированных нейронных сетей и цифровых двойников. Она позволяет моделировать сложные физические процессы с использованием GPU-ускорения и интеграции PyTorch, ориентируясь на задачи инженерии, науки и индустрии. PhysicsNeMo поддерживает масштабируемое обучение, автоматизацию исследований и быстрое внедрение ИИ в симуляционном моделировании и оптимизации.
Наличие по запросу