Внимание
Мы работаем в штатном режиме. Наши склады готовы поставлять оборудование клиентам из Российской Федерации несмотря на санкционные запреты ЕС и США. Оборудование в РФ ввозится легально благодаря новому законодательству с параллельным импортом. Звоните и уточняйте! Информация актуальна на 12.11.26В связи с участившимися случаями недобросовестной конкуренции обращаем ваше внимание, что мы не передаем персональные данные третьим лицам


Поиск по сайту


Серверы для ИИ и нейросетей, страница 73
Фильтр
Наличие по запросу
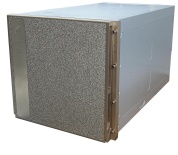


Сервер NVIDIA DGX-2 — это высокопроизводительная платформа, предназначенная для решения самых сложных задач в области искусственного интеллекта и глубокого обучения. Оснащённый 16 графическими ускорителями NVIDIA Tesla V100 с общей памятью 512 ГБ HBM2 и двумя процессорами Intel Xeon Platinum 8168, DGX-2 обеспечивает пиковую производительность до 2 петафлопс. Благодаря использованию технологии NVSwitch с пропускной способностью 2,4 ТБ/с, сервер позволяет эффективно обучать крупномасштабные нейронные сети, ранее считавшиеся невозможными для реализации.
Максимальное количество GPU
16
Тип поддерживаемых GPU
16x встроенных GPU
Совместимые GPU
NVIDIA V1003
Форм-фактор
10U
CPU
Intel Xeon
Максимальное количество процессоров
2
Слоты для оперативной памяти
24
HDD
2x 2.5" NVMe, 8x 2.5" NVMe
Тип оперативной памяти
DDR4
Блок питания
1600W, 2000W
Страна бренда

Наличие по запросу
Наличие по запросу
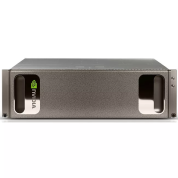
Сервер NVIDIA DGX-1 — это специализированная платформа для задач глубокого обучения и искусственного интеллекта. Он оснащён восемью GPU-ускорителями NVIDIA Tesla P100 или V100, объединёнными через высокоскоростную шину NVLink, двумя процессорами Intel Xeon E5-2698 v4, 512 ГБ оперативной памяти DDR4 и четырьмя SSD по 1,92 ТБ в конфигурации RAID 0 . DGX-1 обеспечивает пиковую производительность до 170 терафлопс (с GPU P100) или до 960 терафлопс (с GPU V100) в вычислениях половинной точности (FP16), что делает его идеальным решением для обучения нейросетей и анализа больших данных .
Максимальное количество GPU
8
Тип поддерживаемых GPU
8x встроенных GPU
Совместимые GPU
NVIDIA P1002
Форм-фактор
3U
CPU
Intel Xeon
Максимальное количество процессоров
2
Слоты для оперативной памяти
16
HDD
4x 2.5" SATA
Тип оперативной памяти
DDR4
Блок питания
1200W
Страна бренда
Наличие по запросу
Наличие по запросу


NVIDIA GB300 NVL72 — это система с полностью жидкостным охлаждением, которая объединяет 72 графических процессора NVIDIA Blackwell Ultra и 36 процессоров NVIDIA Grace™ на базе Arm® в единую платформу, оптимизированную для масштабирования во время тестирования.
Максимальное количество GPU
72
Тип поддерживаемых GPU
72x встроенных GPU
Совместимые GPU
NVIDIA Blackwell Ultra B300
CPU
NVIDIA Blackwell
Страна бренда
Наличие по запросу
Наличие по запросу


NVIDIA GH200 Grace Hopper Superchip - это революционный процессор, разработанный с нуля для крупномасштабных приложений искусственного интеллекта и высокопроизводительных вычислений (HPC). Superchip обеспечивает в 10 раз более высокую производительность приложений, работающих с терабайтами данных, позволяя ученым и исследователям находить беспрецедентные решения самых сложных проблем в мире.
Страна бренда
Наличие по запросу
Наличие по запросу
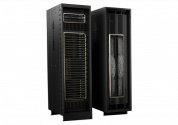


NVidia B200 NVL72 — это фактически серверная стойка, которая объединяет в себе 36 Grace Blackwell Superchip и пару коммутаторов NVSwitch 7.2T.
Максимальное количество GPU
72
Тип поддерживаемых GPU
72x встроенных GPU
Совместимые GPU
NVIDIA Blackwell B200
CPU
NVIDIA Grace
Тип видеопамяти
HBM3E
Архитектура
Blackwell
Страна бренда
Объем видеопамяти
13,5 TB
Наличие по запросу
Наличие по запросу

Флагманским ускорителем на новой архитектуре станет Nvidia Grace Blackwell Superchip, в котором сочетается пара графических процессоров B200 и центральный Arm-процессор Nvidia Grace с 72 ядрами Neoverse V2.
Тип видеопамяти
HBM3E
Архитектура
Blackwell
Страна бренда
Объем видеопамяти
384 GB
Наличие по запросу
Наличие по запросу

ИИ-графические процессоры Blackwell B200 выполнены на новой архитектуре Blackwell. Графический процессор B200 выполнен по 4-нанометровому техпроцессу компании TSMC и содержит в себе 208 млн транзисторов.
Тип видеопамяти
HBM3E
Архитектура
Blackwell
Страна бренда
Объем видеопамяти
192 GB
Наличие по запросу
Наличие по запросу

Instinct MI300X представляет собой ускоритель на основе GPU и является специализированным ускорителем вычислений Instinct MI300X, предназначенным для работы с огромными объемами данных для генеративного ИИ и высокопроизводительных вычислительных нагрузок. Это самый мощный ускоритель вычислений в арсенале AMD.
Форм-фактор
Модуль ОАМ
Наличие по запросу
Наличие по запросу

Instinct MI300X представляет собой ускоритель на основе GPU и является специализированным ускорителем вычислений Instinct MI300X, предназначенным для работы с огромными объемами данных для генеративного ИИ и высокопроизводительных вычислительных нагрузок. Это самый мощный ускоритель вычислений в арсенале AMD.
Форм-фактор
Модуль ОАМ
Наличие по запросу
Наличие по запросу

Интеллектуальный модуль MLU220-SOM использует новую архитектуру MLUv02 и может обеспечить единую систему с вычислительной мощностью AI 16TOPS на модуле размером с кредитную карту с энергопотреблением всего 15 Вт.
Объем видеопамяти
8 GB
Наличие по запросу
Наличие по запросу

Интеллектуальный ускоритель Cambrian Xuansi 1000 объединяет четыре интеллектуальных чипа Siyuan 290 в корпусе высотой 2U. Два ускорителя Xuansi 1000 и сервер ЦП могут образовывать полную систему, включающую 8 карт ускорителей, которые могут обеспечить вычислительную мощность искусственного интеллекта.
Форм-фактор
2U
Объем видеопамяти
128 GB
Наличие по запросу
Наличие по запросу

Интеллектуальная плата-ускоритель MLU290-M5 оснащена первым обучающим чипом Cambrian Siyuan 290, который использует передовую 7-нм техпроцесс TSMC и расширенную архитектуру MLUv02. Интеллектуальная плата-ускоритель MLU290-M5 использует дизайн OAM с открытым модулем ускорения и имеет 64 ядра MLU, пропускную способность памяти 1,23 ТБ/с и новую технологию межчипового соединения MLU-Link.
Объем видеопамяти
32 GB
Наличие по запросу